
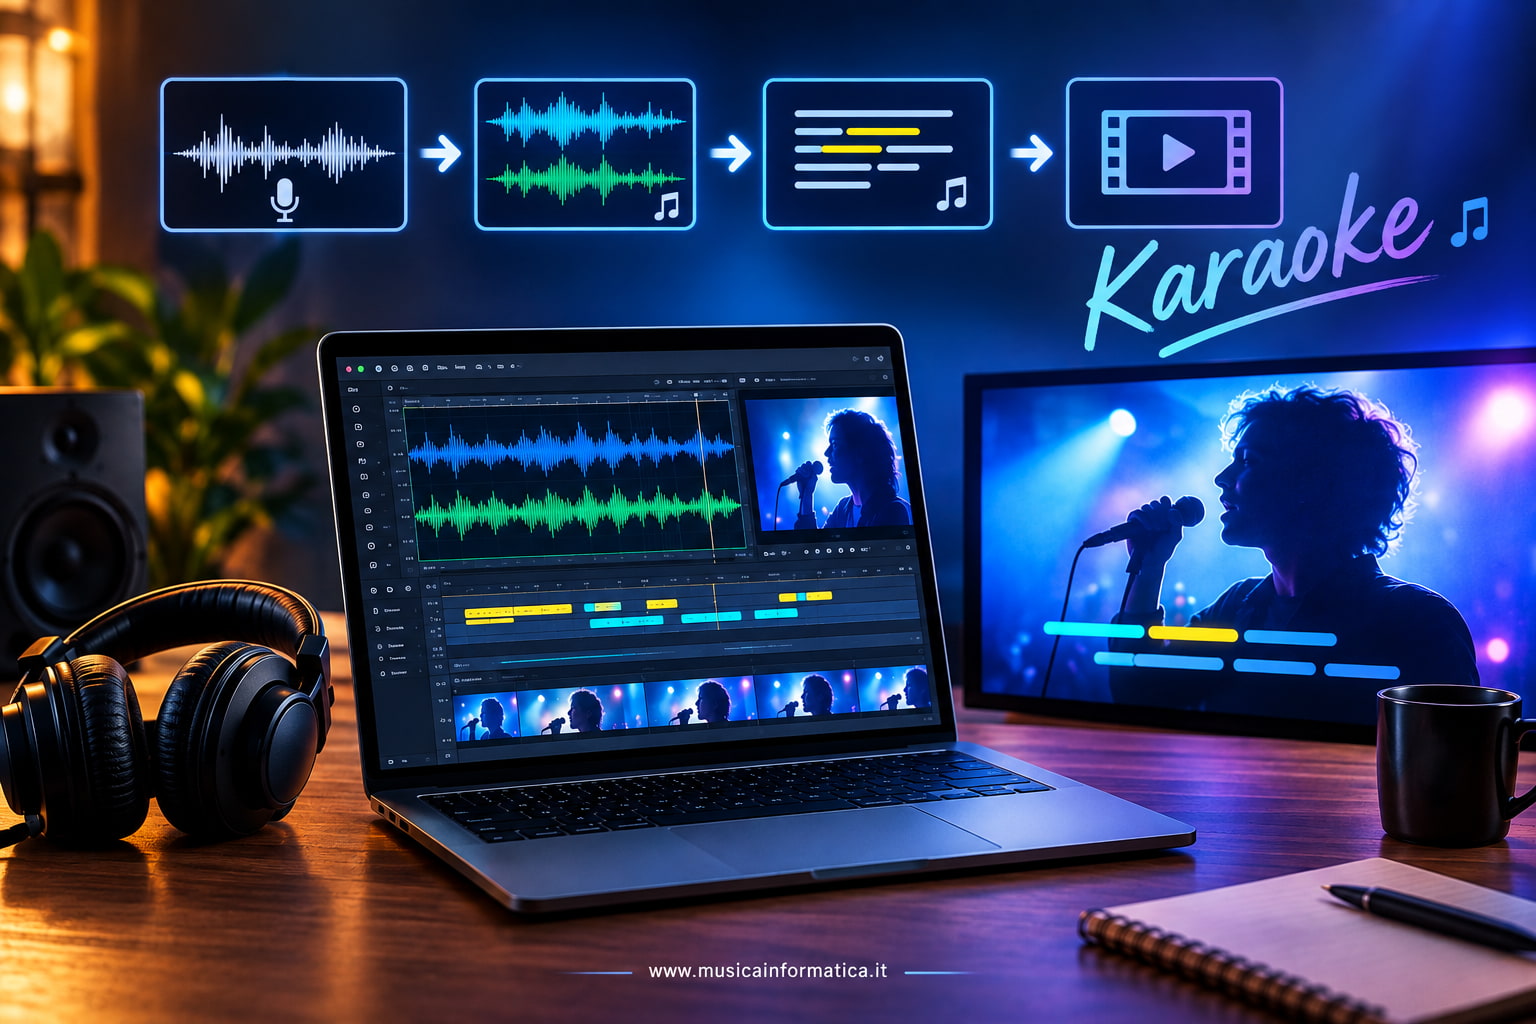
Creare una versione karaoke di un brano è un problema che si risolve in un solo passaggio soltanto nelle pagine che vogliono venderti un abbonamento. Nella pratica è una catena di quattro stadi distinti: si separa la voce dalla base, si ripulisce la traccia strumentale ottenuta, si allinea il testo all’audio parola per parola, si assembla il video. Ogni stadio produce un file che alimenta quello successivo, e ognuno può essere fermato prima se ciò che serve è soltanto la base.
Questa guida percorre l’intera catena da riga di comando, con strumenti liberi che girano interamente in locale: nessun caricamento su servizi esterni, nessun limite di durata, nessuna filigrana sul risultato. Il presupposto è una certa dimestichezza con il terminale e con gli ambienti virtuali di Python. Molti degli strumenti citati qui sono già stati presentati nell’articolo dedicato agli strumenti di intelligenza artificiale utilizzabili da terminale, a cui rimando per l’installazione di base e per il contesto generale.
Se il terminale non fa parte dei tuoi strumenti abituali, esiste una versione di questo stesso flusso realizzabile interamente con interfacce grafiche.
Che cosa serve prima di iniziare
I prerequisiti sono pochi ma non negoziabili: Python 3.10 o superiore, ffmpeg installato e raggiungibile dal PATH, e un ambiente virtuale dedicato, perché gli strumenti che seguono hanno dipendenze che tendono a litigare tra loro.
python -m venv karaoke-env
source karaoke-env/bin/activate      # su Windows: karaoke-env\Scripts\activate
Una GPU Nvidia riduce i tempi di elaborazione di un ordine di grandezza, ma non è obbligatoria: su CPU un brano di quattro minuti richiede qualche minuto invece di qualche secondo, il che è perfettamente accettabile se non devi elaborare un intero catalogo.
Conta molto, invece, la qualità del file di partenza. I modelli di separazione lavorano sullo spettro del segnale, e un MP3 a basso bitrate ha già perso informazione nelle alte frequenze, esattamente dove risiedono le componenti che distinguono la voce dagli strumenti. Partire da un WAV o da un FLAC produce una base sensibilmente più pulita. Se hai solo un MP3, usalo pure, ma sappi che il limite del risultato è stato fissato prima ancora di iniziare.
Separare la voce dalla base con Demucs
Demucs è il modello di separazione sviluppato da Meta ed è il punto di partenza naturale, perché è ben documentato, si installa con un comando e non richiede scelte iniziali.
pip install demucsPer il karaoke non servono quattro tracce separate: serve la voce da una parte e tutto il resto dall’altra. È esattamente ciò che fa la modalità a due stem:
demucs --two-stems=vocals brano.wavIl risultato finisce in separated/htdemucs/brano/ sotto forma di due file: vocals.wav, la voce isolata, e no_vocals.wav, la base strumentale. Entrambi servono, ed è un punto che sfugge quasi sempre: la base è ciò su cui si canterà, ma la voce isolata è il materiale su cui più avanti si allineerà il testo, e senza di essa lo stadio di sincronizzazione dà risultati molto peggiori.
Vale la pena conoscere tre opzioni. Il modello rifinito htdemucs_ft è più lento di circa quattro volte ma restituisce una separazione migliore, e a parità di tempo speso è quasi sempre la scelta giusta. Il flag --shifts esegue più passaggi con lievi sfasamenti temporali e ne media il risultato, riducendo gli artefatti. Il formato di uscita può essere compresso se lo spazio è un problema, ma per gli stadi successivi conviene restare su file non compressi.
demucs -n htdemucs_ft --two-stems=vocals --shifts=2 brano.wavQuale modello scegliere per la separazione
Qui si gioca la qualità del risultato finale, ed è la parte che la maggior parte delle guide salta.
Demucs è versatile ma non è il migliore su ogni compito. La comunità raccolta attorno a Ultimate Vocal Remover ha addestrato negli anni decine di modelli specializzati, e la buona notizia è che non serve installare l’applicazione grafica per usarli: il pacchetto audio-separator li rende disponibili da terminale, scaricandoli automaticamente al primo utilizzo.
pip install "audio-separator[gpu]"     # oppure [cpu]
audio-separator --list_models
audio-separator brano.wav --model_filename UVR-MDX-NET-Inst_HQ_3.onnx
Il criterio di scelta è meno intuitivo di quanto sembri, perché i modelli non sono simmetrici. Un modello addestrato a estrarre la parte strumentale e uno addestrato a estrarre la voce non producono lo stesso risultato con i ruoli invertiti: ciascuno è ottimizzato per preservare il proprio bersaglio, e sacrifica l’altro. Per una base karaoke serve un modello di tipo strumentale, tipicamente uno della famiglia Inst, che protegge gli strumenti anche a costo di lasciare qualche residuo vocale. Per la voce isolata destinata all’allineamento del testo serve un modello di tipo vocale, come quelli della famiglia Kim_Vocal.
Questo porta a una conseguenza pratica che vale il tempo che costa: conviene eseguire due passaggi con due modelli diversi, uno per la base su cui si canterà e uno per la voce da dare in pasto all’allineatore, invece di usare i due stem complementari di un’unica esecuzione.
Esiste poi un caso particolare che merita attenzione. Nei brani con cori e armonie, togliere ogni traccia vocale rende la base povera e innaturale: il karaoke funziona meglio se resta il tessuto dei cori e sparisce solo la voce solista. Per questo esistono modelli specifici, riconoscibili dalla dicitura KARA, addestrati proprio a distinguere la linea principale dalle voci di supporto.
Due parole sullo stato dell’arte, perché il panorama si è mosso. I modelli della famiglia Roformer sono oggi i più performanti sull’isolamento vocale, con un’architettura a trasformatori che lavora su bande di frequenza e restituisce stem particolarmente puliti; sono più lenti, e ha senso rivolgersi a loro quando la qualità conta più del tempo. Spleeter, invece, è il nome che compare in quasi tutti i tutorial più vecchi: è un modello del 2019, resta velocissimo, ma il divario di qualità rispetto a quanto è disponibile oggi è ormai chiaramente udibile. Se hai trovato una guida che lo consiglia come prima scelta, quella guida ha qualche anno sulle spalle.
Ripulire la traccia strumentale
La separazione non è mai perfetta e lascia tre tipi di residuo: frammenti di consonanti nei passaggi in cui la voce era molto in primo piano, code di riverbero appartenenti alla voce rimossa ma non rimosse insieme a essa, e un generale assottigliamento delle medie frequenze là dove il modello ha tolto più del dovuto.
Il riverbero residuo è il problema più fastidioso e ha una soluzione elegante: gli stessi modelli usati per separare comprendono varianti addestrate alla rimozione del riverbero, applicabili come secondo passaggio sulla base già ottenuta. Vale la pena cercarle nell’elenco dei modelli disponibili filtrando per compito.
Il livellamento del volume si risolve invece con ffmpeg, usando il filtro di normalizzazione conforme allo standard di loudness:
ffmpeg -i no_vocals.wav -af loudnorm=I=-16:TP=-1.5:LRA=11 base.wavC’è poi un intervento che per il karaoke non è un dettaglio estetico ma una funzione: il cambio di tonalità. Poche persone cantano comodamente nella tonalità originale del brano, e poter abbassare o alzare la base di uno o due semitoni cambia la fruibilità del risultato. L’operazione va fatta modificando l’altezza senza toccare la durata, cosa che sox esegue in modo affidabile misurando lo spostamento in centesimi di semitono:
sox base.wav base-2semitoni.wav pitch -200Il valore negativo abbassa, quello positivo alza, e duecento centesimi corrispondono a due semitoni. Se la tua installazione di ffmpeg include la libreria Rubber Band, il filtro rubberband fa la stessa cosa restando dentro un solo strumento, ma non è compilato di serie in tutte le distribuzioni.
Per interventi più chirurgici, come un’equalizzazione mirata su un passaggio specifico o la cancellazione manuale di un frammento vocale sopravvissuto, la riga di comando diventa scomoda e conviene aprire Audacity per una rifinitura facoltativa. È un lavoro di pochi minuti che si fa una volta sola, e la resa cambia parecchio.
Ottenere il testo sincronizzato con l’audio
Questo è lo stadio concettualmente più interessante, ed è quello in cui l’approccio istintivo è anche quello sbagliato.
L’istinto suggerisce di dare il brano in pasto a un sistema di trascrizione automatica e usarne l’output. Funziona male, per due ragioni. La prima è che i modelli di riconoscimento vocale sono addestrati sul parlato, e il canto ha una prosodia, una durata delle vocali e un’articolazione delle consonanti che li mette in difficoltà. La seconda è che sopra la voce c’è tutta la strumentazione, che il modello interpreta come rumore.
L’approccio corretto rovescia il problema. Il testo della canzone esiste già e non ha bisogno di essere indovinato: quello che serve non è trascriverlo, è collocarlo nel tempo. L’operazione si chiama allineamento forzato, e consiste nel dare a un modello sia l’audio sia il testo esatto, chiedendogli soltanto di stabilire in quale istante viene pronunciata ogni parola. È un compito molto più semplice del riconoscimento, e infatti dà risultati molto più accurati.
A questo si aggiunge il vantaggio dello stadio precedente: l’allineamento non va eseguito sul mix completo ma sulla voce isolata, dove non c’è strumentazione a disturbare. È il motivo per cui abbiamo conservato quel file.
Lo strumento di riferimento è WhisperX, che estende Whisper con un modello di allineamento fonetico e restituisce timestamp a livello di singola parola.
pip install whisperx
whisperx vocals.wav --language it --model large-v3 --output_format srt
Questo comando trascrive e allinea in un solo passaggio, ed è la strada rapida: produce un file di sottotitoli già temporizzato che poi va corretto nel testo. Per l’allineamento forzato vero e proprio, partendo dal testo corretto che già possiedi, serve invece l’interfaccia Python:
import whisperx

device = "cuda"
audio = whisperx.load_audio("vocals.wav")
durata = len(audio) / 16000

with open("testo.txt", encoding="utf-8") as f:
    testo = " ".join(r.strip() for r in f if r.strip())

segmenti = [{"text": testo, "start": 0.0, "end": durata}]

modello, metadata = whisperx.load_align_model(language_code="it", device=device)
risultato = whisperx.align(segmenti, modello, metadata, audio, device)

for parola in risultato["word_segments"]:
    print(parola["start"], parola["end"], parola["word"])
Passando l’intero brano come segmento unico si lascia al modello il compito di distribuire le parole lungo tutta la durata. Funziona bene sui brani di lunghezza ordinaria; su tracce molto lunghe conviene spezzare il testo in blocchi corrispondenti a strofe e ritornelli, indicando per ciascuno un intervallo approssimativo.
Esiste un’alternativa storica, aeneas, pensata esattamente per questo compito e capace di allineare un elenco di righe di testo a un file audio. È matura e ben documentata, ma è ferma da anni e l’installazione sulle versioni recenti di Python richiede un po’ di pazienza con le dipendenze. Se WhisperX dà problemi sulla tua macchina, resta una strada percorribile.
Dal testo allineato al formato karaoke
Un file di sottotitoli ordinario mostra una riga alla volta e la sostituisce con la successiva. Non è un karaoke: manca l’elemento che definisce il formato, cioè l’evidenziazione progressiva che avanza sulle parole mentre vengono cantate, dicendo a chi canta non solo che cosa dire ma quando dirlo.
I formati che gestiscono questa informazione sono sostanzialmente due. Il formato LRC, nato per i lettori musicali, nella sua versione estesa associa un timestamp a ogni parola. Il formato ASS, nato per i sottotitoli, dispone di marcatori dedicati proprio all’effetto karaoke: il marcatore \k seguito da una durata espressa in centesimi di secondo indica per quanto tempo resta evidenziata la porzione di testo che segue, mentre la variante \kf produce un riempimento progressivo invece di un cambio netto.
La struttura di una riga è questa:
Dialogue: 0,0:00:12.40,0:00:16.80,Default,,0,0,0,,{\kf45}Nel {\kf38}mezzo {\kf52}del {\kf60}camminLe durate si ricavano direttamente dai timestamp prodotti allo stadio precedente: la durata di ogni parola in centesimi di secondo è la differenza tra il suo istante finale e quello iniziale, moltiplicata per cento. È una conversione che si scrive in poche righe di Python partendo dalla lista word_segments.
Il risultato automatico è quasi sempre corretto ma raramente perfetto: le pause respiratorie, le sillabe tenute lunghe e gli attacchi anticipati richiedono aggiustamenti che l’occhio coglie meglio dell’algoritmo. Aegisub è l’editor storico per questo lavoro e dispone di una modalità dedicata alla temporizzazione karaoke, con la forma d’onda in vista e la possibilità di trascinare i confini delle sillabe. Anche in questo caso si tratta di una rifinitura facoltativa, ma su un brano destinato a essere usato davvero valgono i dieci minuti che richiede.
Generare il video con ffmpeg
L’ultimo stadio assembla i pezzi: la base strumentale ripulita, il file di sottotitoli temporizzato e un’immagine di sfondo diventano un video.
ffmpeg -loop 1 -i sfondo.jpg -i base.wav \
  -vf "ass=testo.ass" \
  -c:v libx264 -tune stillimage -pix_fmt yuv420p \
  -c:a aac -b:a 192k -shortest karaoke.mp4
Il flag -loop 1 ripete l’immagine fissa per tutta la durata, -shortest interrompe la codifica quando finisce l’audio, e -pix_fmt yuv420p garantisce che il file sia leggibile ovunque, cosa che senza questa opzione non è scontata. Il filtro ass incolla i sottotitoli nell’immagine, rendendoli parte del video: è ciò che serve, perché un sottotitolo separato non verrebbe visualizzato con la temporizzazione karaoke sulla maggior parte dei lettori.
Un avvertimento sui caratteri tipografici: il file ASS indica il font per nome, e ffmpeg lo cerca tra quelli installati nel sistema. Se il nome non corrisponde a nulla, la sostituzione avviene in silenzio e il risultato ha un aspetto diverso da quello previsto senza che nessun messaggio lo segnali.
Chi preferisce uno sfondo animato a un’immagine fissa può generarlo dalla base stessa, sostituendo l’immagine con una visualizzazione della forma d’onda o dello spettro prodotta dai filtri showwaves e showspectrum. È un dettaglio estetico, ma evita di dover procurare un’immagine per ogni brano.
Automatizzare il flusso su più brani
Una volta che la catena funziona su un brano, ha senso incapsularla. Ogni stadio è un comando che accetta un file e ne produce un altro, quindi l’intero flusso si riduce a uno script che itera su una cartella:
#!/bin/bash
for brano in sorgenti/*.wav; do
    nome=$(basename "$brano" .wav)
    demucs -n htdemucs_ft --two-stems=vocals -o lavorazione "$brano"
    ffmpeg -i "lavorazione/htdemucs_ft/$nome/no_vocals.wav" \
           -af loudnorm=I=-16:TP=-1.5:LRA=11 "basi/$nome.wav"
done
Il punto in cui l’automazione si ferma è l’allineamento del testo, che richiede il testo di ciascun brano come input. La soluzione ragionevole è tenere accanto a ogni file audio un file di testo omonimo e far leggere allo script la coppia. Il rendering finale, invece, si automatizza senza attriti.
Conviene inserire un controllo di esistenza dei file intermedi, in modo che rilanciare lo script non ripeta le elaborazioni già completate: la separazione è lo stadio costoso, e ripeterla per errore su una cartella intera è una serata persa.
Conclusioni
Il flusso descritto qui non è un compromesso al ribasso rispetto ai servizi a pagamento: usa gli stessi modelli, elabora file di qualsiasi durata, non impone filigrane e non invia nulla all’esterno. Il prezzo è il tempo di configurazione iniziale, che però si paga una volta sola.
Il punto su cui vale la pena tornare è la scelta del modello di separazione, perché è lì che si decide il risultato: due passaggi con modelli specializzati diversi, uno per la base e uno per la voce da allineare, valgono più di qualsiasi rifinitura successiva.
Gli strumenti citati si trovano alle rispettive pagine ufficiali: Demucs su github.com/adefossez/demucs, audio-separator su github.com/nomadkaraoke/python-audio-separator, WhisperX su github.com/m-bain/whisperX, Aegisub su aegisub.org e Audacity su audacityteam.org. La documentazione dei filtri di ffmpeg è su ffmpeg.org/ffmpeg-filters.html.
Un’ultima nota per chi intende pubblicare il risultato. Realizzare una base karaoke per uso personale è una cosa; diffonderla su piattaforme pubbliche è un’altra, e richiede licenze che riguardano tanto la composizione quanto la registrazione da cui si è partiti. Vale la pena verificarlo prima di caricare qualcosa.
Lascia un commento